Domain datx.de kaufen?
Wir ziehen mit dem Projekt
datx.de um.
Sind Sie am Kauf der Domain
datx.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain datx.de kaufen?
Ist Big Data eine Technologie?
Ist Big Data eine Technologie? Big Data ist eigentlich kein spezifisches Technologieprodukt, sondern vielmehr ein Konzept oder eine Herangehensweise, um große Mengen an Daten zu sammeln, zu speichern, zu analysieren und zu nutzen. Es umfasst verschiedene Technologien und Tools wie Datenbanken, Data Mining, maschinelles Lernen und künstliche Intelligenz, die verwendet werden, um Erkenntnisse aus den Daten zu gewinnen. Daher kann man sagen, dass Big Data eher eine Strategie oder ein Framework ist, das auf verschiedenen Technologien basiert, anstatt eine eigenständige Technologie zu sein. Letztendlich zielt Big Data darauf ab, Unternehmen dabei zu unterstützen, fundierte Entscheidungen auf der Grundlage von Daten zu treffen und Wettbewerbsvorteile zu erlangen. **
Wie können Machine-Learning-Algorithmen zur Vorhersage zukünftiger Ereignisse eingesetzt werden?
Machine-Learning-Algorithmen analysieren historische Daten, um Muster und Trends zu identifizieren. Anhand dieser Muster können sie zukünftige Ereignisse vorhersagen. Die Algorithmen werden trainiert, um präzise Prognosen zu erstellen und Entscheidungen zu unterstützen. **
Ähnliche Suchbegriffe für Selten
Top-Angebote
Produkte zum Begriff Selten:
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Welche Anwendungen und Entwicklungen haben Machine Learning-Algorithmen in verschiedenen Branchen hervorgebracht?
Machine Learning-Algorithmen haben in der Gesundheitsbranche Anwendungen wie die Diagnose von Krankheiten und die personalisierte Medizin ermöglicht. In der Finanzbranche werden sie für die Betrugserkennung und die Risikobewertung eingesetzt. Im Bereich des Marketings helfen sie bei der Kundenanalyse und der personalisierten Werbung. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **

Welche Methoden zur Dimensionalitätsreduktion eignen sich besonders gut zur Optimierung von Machine-Learning-Algorithmen?
Hauptkomponentenanalyse (PCA) ist eine beliebte Methode zur Reduzierung der Dimensionalität von Daten, indem sie die Varianz maximiert und irrelevante Informationen eliminiert. Eine weitere effektive Methode ist die t-Distributed Stochastic Neighbor Embedding (t-SNE), die komplexe Datenstrukturen in einem niedrigdimensionalen Raum visualisiert. Feature Selection-Techniken wie Recursive Feature Elimination (RFE) können auch verwendet werden, um die relevantesten Merkmale für die Modellierung auszuwählen. **
Wie können Machine Learning-Algorithmen dabei helfen, große Datenmengen zu analysieren und Muster zu erkennen?
Machine Learning-Algorithmen können große Datenmengen verarbeiten und Muster erkennen, die für menschliche Analysten schwer zu erkennen sind. Sie können automatisch Muster identifizieren und Vorhersagen treffen, ohne dass explizite Regeln programmiert werden müssen. Durch kontinuierliches Lernen können sie auch mit sich ändernden Daten umgehen und ihre Genauigkeit im Laufe der Zeit verbessern. **
Top-Angebote
Produkte zum Begriff Selten:
-
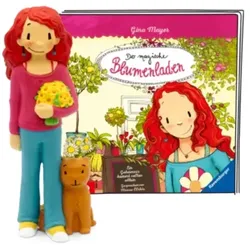
tonies® 10000794 Der magische Blumenladen – Ein Geheimnis kommt selten alleinEine Hörfigur für die Toniebox. Sie sind „Datenträger“ und Spielzeug zugleich. Jeder Tonie hat seinen eigenen Hörinhalt. Sie sind magnethaftend und bleiben so auf der Toniebox stehen. Für Violet gibt es keinen schöneren Ort auf der Welt als Tante Abigails Blumenladen. Dort duftet es so herrlich – nach Veilchen, Rosen und Geheimnissen ! Violet platzt fast vor Neugier. Wieso bloß kommen immer wieder Leute in den Laden, flüstern mit Tante Abigail und gehen ohne eine einzige Blume, dafür aber mit einem Lächeln auf den Lippen? Hat das etwa mit dem uralten magischen Blumenbuch zu tun, das Violet eines Tages findet? Zusammen mit ihren besten Freunden Jack und Zack geht sie den Rätseln auf den Grund. Produktdetails Hörbuch Altersempfehlung: Ab 7 Jahren Laufzeit: 77 Minuten Zubehör: Booklet, Bedienungsanleitung Hinweis: Achtung. Nicht für Kinder unter 36 Monaten geeignet. Kleine Teile. Erstickungsgefahr. WLAN mit Internetverbindung und Toniebox erforderlich.39,99 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
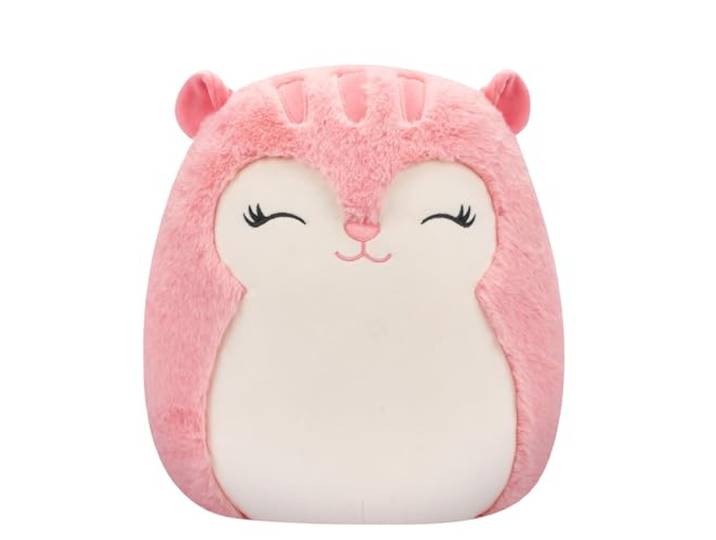
Squishmallow FuzzAMallows Plüschtier Amina das Eichhörnchen 30 cm – Ultra Selten - Squishmallows KuscheltiereSquishmallow FuzzAMallows Plüschtier Amina das Eichhörnchen 30 cm – Ultra Selten - Squishmallows Kuscheltiere. Squishmallows 30 cm Amina das Eichhörnchen – Extrem selten mit dem Etikett „Extrem selten “.\nErweitern Sie Ihr Squishmallows-Team mit diesem 30 cm großen Plüschtier.\nNehmen Sie dieses entzückende Plüschtier mit auf lange Autofahrten, Flugzeuge, Filmmarathons und mehr.\nSquishmallows verleihen Squishmallows eine flauschige Note! Fügen Sie dieses entzückende Plüschtier Ihrem Squishmallow-Team hinzu!\nDieser extrem zusammendrückbare 30-cm-Plüsch besteht aus hochwertigen und ultraweichen Materialien. Farbe:Pink126,88 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Ist Big Data eine Technologie?
Ist Big Data eine Technologie? Big Data ist eigentlich kein spezifisches Technologieprodukt, sondern vielmehr ein Konzept oder eine Herangehensweise, um große Mengen an Daten zu sammeln, zu speichern, zu analysieren und zu nutzen. Es umfasst verschiedene Technologien und Tools wie Datenbanken, Data Mining, maschinelles Lernen und künstliche Intelligenz, die verwendet werden, um Erkenntnisse aus den Daten zu gewinnen. Daher kann man sagen, dass Big Data eher eine Strategie oder ein Framework ist, das auf verschiedenen Technologien basiert, anstatt eine eigenständige Technologie zu sein. Letztendlich zielt Big Data darauf ab, Unternehmen dabei zu unterstützen, fundierte Entscheidungen auf der Grundlage von Daten zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Wie können Machine-Learning-Algorithmen zur Vorhersage zukünftiger Ereignisse eingesetzt werden?
Machine-Learning-Algorithmen analysieren historische Daten, um Muster und Trends zu identifizieren. Anhand dieser Muster können sie zukünftige Ereignisse vorhersagen. Die Algorithmen werden trainiert, um präzise Prognosen zu erstellen und Entscheidungen zu unterstützen. **
-
Welche Anwendungen und Entwicklungen haben Machine Learning-Algorithmen in verschiedenen Branchen hervorgebracht?
Machine Learning-Algorithmen haben in der Gesundheitsbranche Anwendungen wie die Diagnose von Krankheiten und die personalisierte Medizin ermöglicht. In der Finanzbranche werden sie für die Betrugserkennung und die Risikobewertung eingesetzt. Im Bereich des Marketings helfen sie bei der Kundenanalyse und der personalisierten Werbung. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
Ähnliche Suchbegriffe für Selten
-
Smoke Factory Data II 2,6KW Fog MachineSmoke Factory Data II 2,6KW Fog Machine, Data II 2,6KW Fog Machine. Die neue Generation der "klassischen" Power- Nebelmaschinen. Digitale Powernebelmaschine mit zwei Pumpen. 230 V/ 2600 W. Externer Ausgang für optionalen Lüfter für max. 800 W, extrem starker Nebelausstoß, Mengenre - gulierung zwischen 1 % und 99 %. DMX, Timer und Schlauchblende serienmäßig. Dauer - nebel bei reduziertem Ausstoß. Achtung: Bitte verwenden Sie nur das original Smoke Factory Fluid. Andere Fluide führen zum Verstopfen des Gerätes und ein GARANTIE Anspruch erlischt in diesem Fall!1225,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
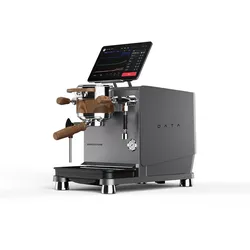
Wendougee DATA-S Dual Boiler Espresso Machine – Black/SilverPrecision for your taste. With the Wendougee DATA-S, you precisely control pressure and flow via a gear pump. Save your brewing profiles in the E-Bar app. The saturated brew group and PID control ensure a consistent temperature. Two boilers and the choice between a tank and fixed water connection make this espresso machine the centerpiece of your coffee station. Gear pump with pressure profiling and flow-priority mode 0.8-l brew boiler and 1.8-l steam boiler 1.5-l water tank or fixed water connection Stainless steel casing, steam wand, and hot water spout Tablet optional, not included in the standard delivery.3649,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Welche Methoden zur Dimensionalitätsreduktion eignen sich besonders gut zur Optimierung von Machine-Learning-Algorithmen?
Hauptkomponentenanalyse (PCA) ist eine beliebte Methode zur Reduzierung der Dimensionalität von Daten, indem sie die Varianz maximiert und irrelevante Informationen eliminiert. Eine weitere effektive Methode ist die t-Distributed Stochastic Neighbor Embedding (t-SNE), die komplexe Datenstrukturen in einem niedrigdimensionalen Raum visualisiert. Feature Selection-Techniken wie Recursive Feature Elimination (RFE) können auch verwendet werden, um die relevantesten Merkmale für die Modellierung auszuwählen. **
-
Wie können Machine Learning-Algorithmen dabei helfen, große Datenmengen zu analysieren und Muster zu erkennen?
Machine Learning-Algorithmen können große Datenmengen verarbeiten und Muster erkennen, die für menschliche Analysten schwer zu erkennen sind. Sie können automatisch Muster identifizieren und Vorhersagen treffen, ohne dass explizite Regeln programmiert werden müssen. Durch kontinuierliches Lernen können sie auch mit sich ändernden Daten umgehen und ihre Genauigkeit im Laufe der Zeit verbessern. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.