Domain datx.de kaufen?
Wir ziehen mit dem Projekt
datx.de um.
Sind Sie am Kauf der Domain
datx.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain datx.de kaufen?
Was ist der Unterschied zwischen "antifragile" und "fearless"?
"Antifragile" bezieht sich auf ein System oder eine Person, die von Störungen, Unsicherheit oder Chaos profitiert und daraus gestärkt hervorgeht. Es geht darum, widerstandsfähiger und besser zu werden, wenn man mit Herausforderungen konfrontiert wird. "Fearless" hingegen bedeutet, keine Angst zu haben oder keine Furcht zu empfinden. Es bezieht sich auf eine Person, die mutig und entschlossen handelt, ohne von Ängsten oder Zweifeln beeinflusst zu werden. **
Ist Big Data eine Technologie?
Ist Big Data eine Technologie? Big Data ist eigentlich kein spezifisches Technologieprodukt, sondern vielmehr ein Konzept oder eine Herangehensweise, um große Mengen an Daten zu sammeln, zu speichern, zu analysieren und zu nutzen. Es umfasst verschiedene Technologien und Tools wie Datenbanken, Data Mining, maschinelles Lernen und künstliche Intelligenz, die verwendet werden, um Erkenntnisse aus den Daten zu gewinnen. Daher kann man sagen, dass Big Data eher eine Strategie oder ein Framework ist, das auf verschiedenen Technologien basiert, anstatt eine eigenständige Technologie zu sein. Letztendlich zielt Big Data darauf ab, Unternehmen dabei zu unterstützen, fundierte Entscheidungen auf der Grundlage von Daten zu treffen und Wettbewerbsvorteile zu erlangen. **
Ähnliche Suchbegriffe für Hänssler-Fearless
Top-Angebote
Produkte zum Begriff Hänssler-Fearless:
-
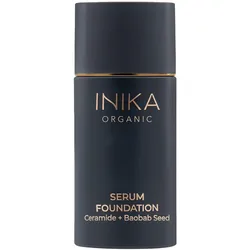
INIKA Serum Foundation Fearless 25 mlEine leichte, aufbaubare Foundation, die sich problemlos wie eine zweite Haut auftragen lässt, mit einem sanften, matten Finish. Angereichert mit hautliebenden Ceramiden und Baobab-Samen trägt das nährende Serum dazu bei, die Feuchtigkeitsbarriere der Haut wieder aufzufüllen und zu schützen. Das federleichte Fluid hebt den natürlichen Teint hervor und sorgt für einen zarten, ebenmäßigen Hautton. Anwendung: Mit den Fingerspitzen oder mit dem INIKA Foundation-Pinsel in die Haut einarbeiten. Wo erwünscht nach und nach Deckkraft aufbauen. Warnhinweis: Gut schütteln. Patch-Test empfohlen. Unter 30°C lagern50,22 €*Versand: 3,99 €Sichere Weiterleitung zum Anbieter


-
Wie können Machine-Learning-Algorithmen zur Vorhersage zukünftiger Ereignisse eingesetzt werden?
Machine-Learning-Algorithmen analysieren historische Daten, um Muster und Trends zu identifizieren. Anhand dieser Muster können sie zukünftige Ereignisse vorhersagen. Die Algorithmen werden trainiert, um präzise Prognosen zu erstellen und Entscheidungen zu unterstützen. **
-
Welche Anwendungen und Entwicklungen haben Machine Learning-Algorithmen in verschiedenen Branchen hervorgebracht?
Machine Learning-Algorithmen haben in der Gesundheitsbranche Anwendungen wie die Diagnose von Krankheiten und die personalisierte Medizin ermöglicht. In der Finanzbranche werden sie für die Betrugserkennung und die Risikobewertung eingesetzt. Im Bereich des Marketings helfen sie bei der Kundenanalyse und der personalisierten Werbung. **
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **


Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
Welche Methoden zur Dimensionalitätsreduktion eignen sich besonders gut zur Optimierung von Machine-Learning-Algorithmen?
Hauptkomponentenanalyse (PCA) ist eine beliebte Methode zur Reduzierung der Dimensionalität von Daten, indem sie die Varianz maximiert und irrelevante Informationen eliminiert. Eine weitere effektive Methode ist die t-Distributed Stochastic Neighbor Embedding (t-SNE), die komplexe Datenstrukturen in einem niedrigdimensionalen Raum visualisiert. Feature Selection-Techniken wie Recursive Feature Elimination (RFE) können auch verwendet werden, um die relevantesten Merkmale für die Modellierung auszuwählen. **
Top-Angebote
Produkte zum Begriff Hänssler-Fearless:
-
Was ist der Unterschied zwischen "antifragile" und "fearless"?
"Antifragile" bezieht sich auf ein System oder eine Person, die von Störungen, Unsicherheit oder Chaos profitiert und daraus gestärkt hervorgeht. Es geht darum, widerstandsfähiger und besser zu werden, wenn man mit Herausforderungen konfrontiert wird. "Fearless" hingegen bedeutet, keine Angst zu haben oder keine Furcht zu empfinden. Es bezieht sich auf eine Person, die mutig und entschlossen handelt, ohne von Ängsten oder Zweifeln beeinflusst zu werden. **
-
Ist Big Data eine Technologie?
Ist Big Data eine Technologie? Big Data ist eigentlich kein spezifisches Technologieprodukt, sondern vielmehr ein Konzept oder eine Herangehensweise, um große Mengen an Daten zu sammeln, zu speichern, zu analysieren und zu nutzen. Es umfasst verschiedene Technologien und Tools wie Datenbanken, Data Mining, maschinelles Lernen und künstliche Intelligenz, die verwendet werden, um Erkenntnisse aus den Daten zu gewinnen. Daher kann man sagen, dass Big Data eher eine Strategie oder ein Framework ist, das auf verschiedenen Technologien basiert, anstatt eine eigenständige Technologie zu sein. Letztendlich zielt Big Data darauf ab, Unternehmen dabei zu unterstützen, fundierte Entscheidungen auf der Grundlage von Daten zu treffen und Wettbewerbsvorteile zu erlangen. **
-
Wie können Machine-Learning-Algorithmen zur Vorhersage zukünftiger Ereignisse eingesetzt werden?
Machine-Learning-Algorithmen analysieren historische Daten, um Muster und Trends zu identifizieren. Anhand dieser Muster können sie zukünftige Ereignisse vorhersagen. Die Algorithmen werden trainiert, um präzise Prognosen zu erstellen und Entscheidungen zu unterstützen. **
-
Welche Anwendungen und Entwicklungen haben Machine Learning-Algorithmen in verschiedenen Branchen hervorgebracht?
Machine Learning-Algorithmen haben in der Gesundheitsbranche Anwendungen wie die Diagnose von Krankheiten und die personalisierte Medizin ermöglicht. In der Finanzbranche werden sie für die Betrugserkennung und die Risikobewertung eingesetzt. Im Bereich des Marketings helfen sie bei der Kundenanalyse und der personalisierten Werbung. **
Ähnliche Suchbegriffe für Hänssler-Fearless
-
INIKA Serum Foundation Fearless 25 mlEine leichte, aufbaubare Foundation, die sich problemlos wie eine zweite Haut auftragen lässt, mit einem sanften, matten Finish. Angereichert mit hautliebenden Ceramiden und Baobab-Samen trägt das nährende Serum dazu bei, die Feuchtigkeitsbarriere der Haut wieder aufzufüllen und zu schützen. Das federleichte Fluid hebt den natürlichen Teint hervor und sorgt für einen zarten, ebenmäßigen Hautton. Anwendung: Mit den Fingerspitzen oder mit dem INIKA Foundation-Pinsel in die Haut einarbeiten. Wo erwünscht nach und nach Deckkraft aufbauen. Warnhinweis: Gut schütteln. Patch-Test empfohlen. Unter 30°C lagern50,22 €*Versand: 3,99 €Sichere Weiterleitung zum Anbieter
-
Herlitz Pouch bag New Batik FearlessDas Herlitz Mäppchen ist ein echter Hingucker. Doch die Pouch Bag kann nicht nur optisch punkten. Das geräumige Hauptfach dieses Mäppchens bietet ausreichend Platz für Stifte aller Art, Mal- und Bastelutensilien, Büroartikel, Kosmetik, Accessoires oder sonstige Habseligkeiten. Ein Reißverschluss sorgt dafür, dass diese Gegenstände sicher verstaut sind. So gehen auch Kleinigkeiten nicht verloren und man hat die wichtigsten Utensilien immer griffbereit. Mit den handlichen Maßen von 19,5 x 6,5 x 9,5 cm passt das Schlampermäppchen dennoch problemlos in jeden Rucksack und in jede Tasche und lässt sich so besonders leicht transportieren. Damit ist die Herlitz Pouch bag der perfekte Begleiter für die Schule, die Uni, den Beruf oder in der Freizeit. Die Pouch bag von Herlitz mit dem Serienmotiv New Batik Fearless in den Farben dunkelblau, blau und türkis trifft jeden Geschmack.10,35 €*Versand: 5,49 €Sichere Weiterleitung zum Anbieter
-
Wilmott, Paul: Grundkurs Machine LearningGrundkurs Machine Learning , Aus der Buchreihe »Informatik verstehen«. Ideal zum Selbststudium , Querlenker > Sportfederung , Erscheinungsjahr: 20200724, Produktform: Kartoniert, Titel der Reihe: Rheinwerk Computing##, Autoren: Wilmott, Paul, Seitenzahl/Blattzahl: 256, Themenüberschrift: COMPUTERS / General, Keyword: Hand-Buch Bücher lernen Studium Grundlagen Kurse Workshops Tutorials Wissen Anleitung Training Ausbildung; Robotik; Informatik verstehen; Programmierung programmieren; KI-Welt AI; Künstliche Intelligenz; Software-Entwicklung; Coder Coden; Neuronale Netze; Deep Learning; Mathematik, Fachschema: Informatik~Programmiersprachen~EDV / Theorie / Allgemeines, Fachkategorie: Informatik~Informationstechnik (IT), allgemeine Themen, Sprache: Deutsch, Warengruppe: HC/Programmiersprachen, Fachkategorie: Programmier- und Skriptsprachen, allgemein, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Verlag: Rheinwerk Verlag GmbH, Länge: 228, Breite: 175, Höhe: 17, Gewicht: 480, Produktform: Klappenbroschur, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Genre: Mathematik/Naturwissenschaften/Technik/Medizin, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0006, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, WolkenId: 232715029,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Verdient man Geld beim Praktikum in den Bereichen Data Science oder Machine Learning?
Es hängt von verschiedenen Faktoren ab, ob man Geld während eines Praktikums in den Bereichen Data Science oder Machine Learning verdient. In einigen Fällen bieten Unternehmen Praktikumsstellen mit einer Vergütung an, insbesondere wenn es sich um größere Unternehmen handelt. In anderen Fällen kann es sein, dass Praktika unbezahlt sind oder nur eine geringe Aufwandsentschädigung bieten. Es ist wichtig, die individuellen Bedingungen des Praktikums zu prüfen, um herauszufinden, ob eine Vergütung angeboten wird. **
-
Wie wichtig ist das Fach Theoretische Informatik für Data Science und Machine Learning?
Das Fach Theoretische Informatik ist für Data Science und Machine Learning nicht unbedingt unverzichtbar, aber es kann dennoch von Vorteil sein. Theoretische Informatik vermittelt grundlegende Konzepte und Algorithmen, die in vielen Bereichen der Informatik relevant sind, einschließlich Data Science und Machine Learning. Ein solides Verständnis der theoretischen Grundlagen kann helfen, komplexe Probleme besser zu verstehen und effiziente Lösungen zu entwickeln. **
-
Was sind die potenziellen Anwendungen von Zufallsalgorithmen in der Datenanalyse und Machine Learning?
Zufallsalgorithmen können verwendet werden, um Daten zu generieren, zu transformieren oder zu erweitern, was die Trainingsdaten für Machine Learning verbessern kann. Sie können auch zur Erzeugung von Unsicherheitsschätzungen in Vorhersagemodellen verwendet werden. Darüber hinaus können Zufallsalgorithmen in der Optimierung von Modellparametern eingesetzt werden, um bessere Ergebnisse zu erzielen. **
-
Welche Methoden zur Dimensionalitätsreduktion eignen sich besonders gut zur Optimierung von Machine-Learning-Algorithmen?
Hauptkomponentenanalyse (PCA) ist eine beliebte Methode zur Reduzierung der Dimensionalität von Daten, indem sie die Varianz maximiert und irrelevante Informationen eliminiert. Eine weitere effektive Methode ist die t-Distributed Stochastic Neighbor Embedding (t-SNE), die komplexe Datenstrukturen in einem niedrigdimensionalen Raum visualisiert. Feature Selection-Techniken wie Recursive Feature Elimination (RFE) können auch verwendet werden, um die relevantesten Merkmale für die Modellierung auszuwählen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.